OCR templates
Las plantillas OCR permiten crear plantillas de OCR zonal que permiten reconocer y extraer texto estructurado de imágenes escaneadas.
Entendiendo las etapas de ejecución de una plantilla OCR:
Reconocer Extracción de datos Guardar datos
Hay dos tipos de campos en las plantillas OCR:
- Campos Validation Control.
- Campos Data Capture.
Los tipos MIME permitidos para la etapa de reconocimiento son:
- PNG
- JPG
- GIF
- BMP
Descripción de los campos Validation Control
Sección titulada «Descripción de los campos Validation Control»Los campos Validation Control se usan solo en la etapa de reconocimiento para ayudar a identificar el documento comprobando el patrón de una sección del documento.
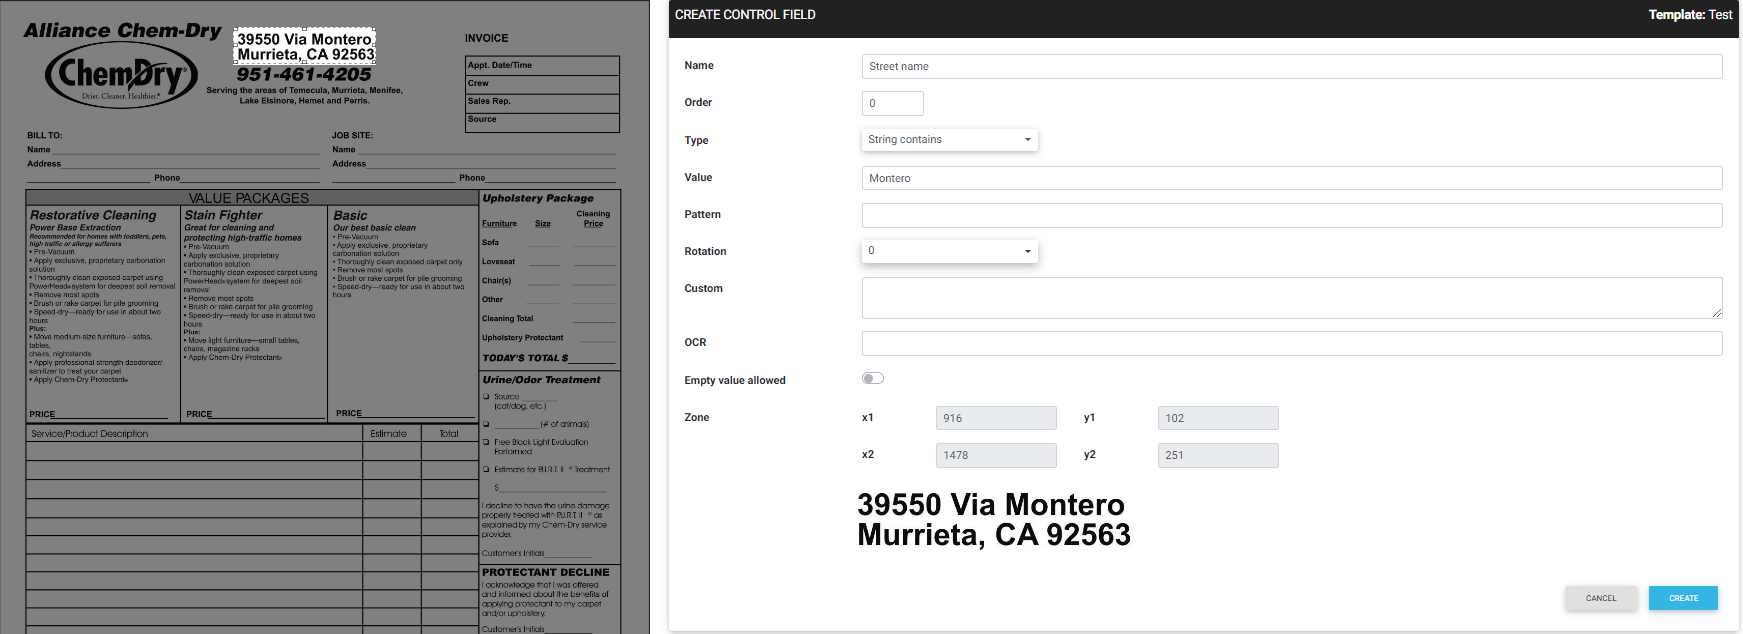
Cada campo Validation Control está compuesto por:
| Field | Description | Required |
|---|---|---|
| Name | Nombre del campo. | true. |
| Order | Orden de evaluación | true. |
| Type | Lista de OCR Validation Controls. Cada validador es una condición que debe cumplirse. | true. |
| Value | Un valor. | * |
| Pattern | Un patrón de expresión regular de Java. | * |
| Rotation | Indica la rotación de imagen que debe aplicarse. Rotaciones de imagen disponibles: - -270 - -180 - -90 - 0 - 90 - 180 - 270 |
true. |
| Custom | Establece comandos para procesar las imágenes para el OCR. Se pueden establecer varios comandos, uno por línea. Por ejemplo, para resaltar el color rojo: /usr/bin/convert ${fileIn} -matte ( +clone -fuzz 50% -transparent red ) -compose DstOut -composite -negate ${fileOut} |
false. |
| OCR | Línea de comandos de OCR. Cuando está presente, se ejecutará en lugar del parámetro de configuración system.ocr. Más información en Parámetros de configuración. Por ejemplo, para forzar la captura de dígitos. /usr/bin/tesseract ${fileIn} ${fileOut} digits |
false. |
| Empty value allowed | Cuando está marcado, indica que un valor de texto OCR vacío también es válido en el proceso de identificación del documento. | false |
| * Estos parámetros se usan en el Validation Control. Pueden ser obligatorios o no según qué Validation Control se use. |
Descripción de los campos Data Capture
Sección titulada «Descripción de los campos Data Capture»Los campos Data Capture se usan para recuperar datos en la etapa de extracción de datos, pero también pueden usarse en la etapa de reconocimiento para ayudar a identificar un documento comprobando el patrón de una sección del documento.
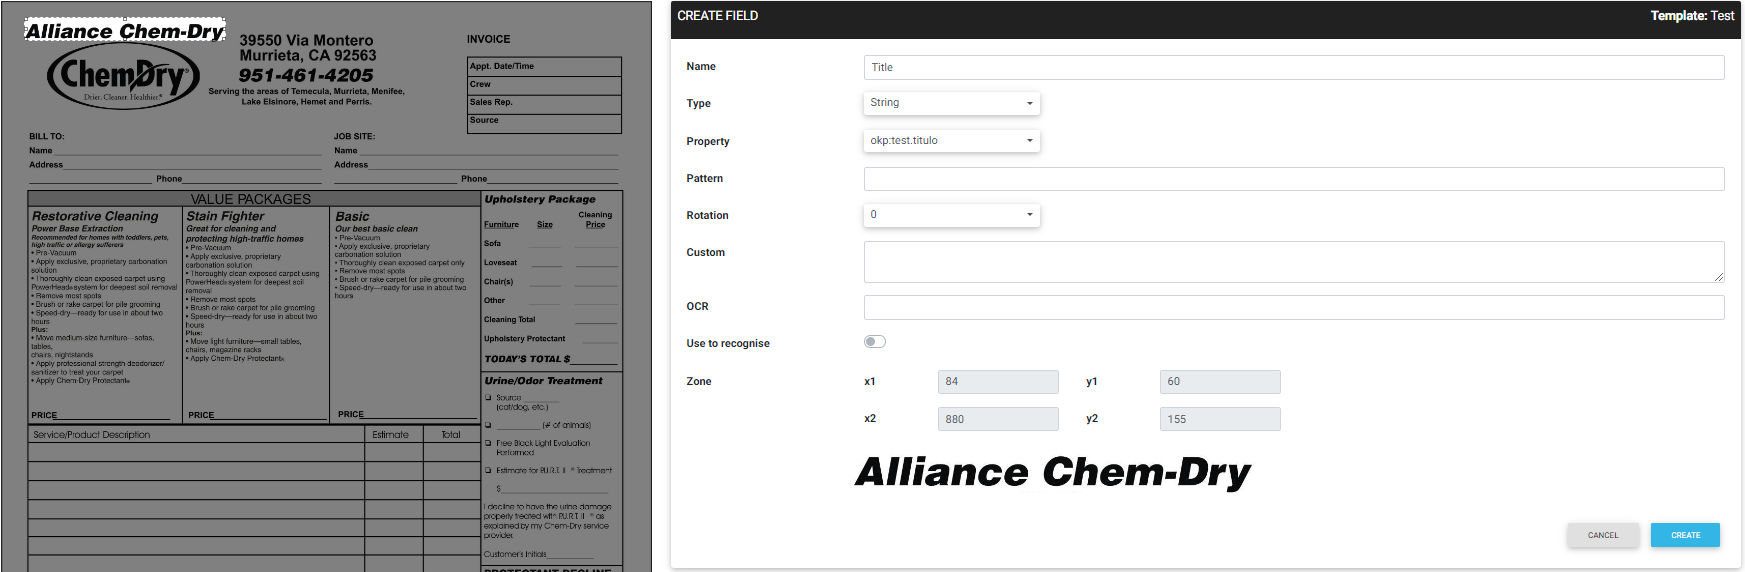
Cada campo Data Capture está compuesto por:
| Field | Description | Required |
|---|---|---|
| Name | Nombre del campo. | true. |
| Order | Orden de evaluación | true. |
| Type | Lista de OCR Data Capture. | true. |
| Property | Campo de metadatos donde se almacenarán los datos capturados. | true. |
| Pattern | Un patrón de expresión regular de Java. | * |
| Rotation | Indica la rotación de imagen que debe aplicarse. Rotaciones de imagen disponibles: - -270 - -180 - -90 - 0 - 90 - 180 - 270 |
true. |
| Custom | Establece comandos para procesar las imágenes para el OCR. Se pueden establecer varios comandos, uno por línea. Por ejemplo, para resaltar el color rojo: /usr/bin/convert ${fileIn} -matte ( +clone -fuzz 50% -transparent red ) -compose DstOut -composite -negate ${fileOut} |
false. |
| OCR | Línea de comandos de OCR. Cuando está presente, se ejecutará en lugar del parámetro de configuración system.ocr. Más información en Parámetros de configuración. Por ejemplo, para forzar la captura de dígitos. /usr/bin/tesseract ${fileIn} ${fileOut} digits |
false. |
| Use to recognise | Cuando se establece en true, indica que el campo también se usará en la etapa de reconocimiento. | false. |
| * Este parámetro se usa en el Data Capture. Puede ser obligatorio o no según qué Data Capture se use. |
Entendiendo OCR Validation Control y OCR Data Capture
Sección titulada «Entendiendo OCR Validation Control y OCR Data Capture»La aplicación proporciona una lista completa de OCR Validation Controls y OCR Data Capture disponibles desde la vista de Plugins. La arquitectura de plugins de la aplicación ayuda a los administradores a añadir nuevas funcionalidades a la aplicación existente.
Por defecto, la aplicación incluye plugins integrados:
También puede crear sus propios plugins:
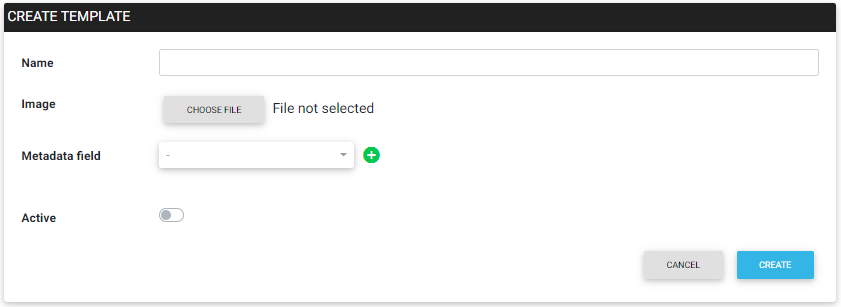
Crear una nueva plantilla OCR
Sección titulada «Crear una nueva plantilla OCR»- En la parte superior derecha, haga clic en
 el icono Nueva plantilla OCR.
- Rellene los campos.
- Campo de metadatos (valores de metadatos estáticos, normalmente usados para identificar el tipo de documento).
- Elija el fichero (tipos MIME permitidos).
- Haga clic en el botón Crear.
- Añada campos Validation Control según sea necesario.
- Validation Controls
- Haga clic en
 Fields.
- Para crear un nuevo Validation Control:
- Haga clic en
 el icono Nuevo campo Validation Control.
- Rellene los campos.
- Elija el área con el ratón en la imagen de la izquierda.
- Haga clic en el botón Crear.
- Haga clic en
- Para editar un Validation Control:
- Haga clic en
 el icono Editar un Validation Control.
- Modifique los campos.
- Haga clic en el botón Editar.
- Haga clic en
- Para eliminar un Validation Control:
- Haga clic en
 el icono Eliminar un Validation Control.
- Haga clic en el botón Eliminar.
- Haga clic en
- Para crear un nuevo Validation Control:
- Haga clic en
- Validation Controls
- Añada campos Data Capture según sea necesario.
- Data Capture
- Haga clic en Fields.
- Para crear un nuevo Data Capture
- Haga clic en el icono Nuevo campo Data Capture.
- Rellene los campos.
- Elija el área con el ratón en la imagen de la izquierda.
- Haga clic en el botón Crear.
- Haga clic en
- Para editar un Data Capture:
- Haga clic en el icono Editar un Data Capture.
- Modifique los campos.
- Haga clic en el botón Editar.
- Haga clic en
- Para eliminar un Data Capture:
- Haga clic en el icono Eliminar un Data Capture.
- Haga clic en el botón Eliminar.
- Haga clic en
- Haga clic en
- Data Capture
Editar una plantilla OCR
Sección titulada «Editar una plantilla OCR»- Haga clic en el icono Editar plantilla OCR.
- Modifique los campos.
- Haga clic en el botón Editar.
Editar los campos de una plantilla OCR
Sección titulada «Editar los campos de una plantilla OCR»Editar un OCR Validation Control
Sección titulada «Editar un OCR Validation Control»Haga clic en Fields.
- Haga clic en el icono Editar un Validation Control.
- Modifique los campos.
- Haga clic en el botón Editar.
Editar un OCR Data Capture
Sección titulada «Editar un OCR Data Capture»Haga clic en Fields.
- Haga clic en el icono Editar un Data Capture.
- Modifique los campos.
- Haga clic en el botón Editar.
Eliminar los campos de una plantilla OCR
Sección titulada «Eliminar los campos de una plantilla OCR»Eliminar un OCR Validation Control
Sección titulada «Eliminar un OCR Validation Control»Haga clic en Fields.
- Haga clic en el icono Eliminar un Validation Control.
- Haga clic en el botón Eliminar.
Eliminar un OCR Data Capture
Sección titulada «Eliminar un OCR Data Capture»Haga clic en Fields.
- Haga clic en el icono Eliminar un Data Capture.
- Haga clic en el botón Eliminar.
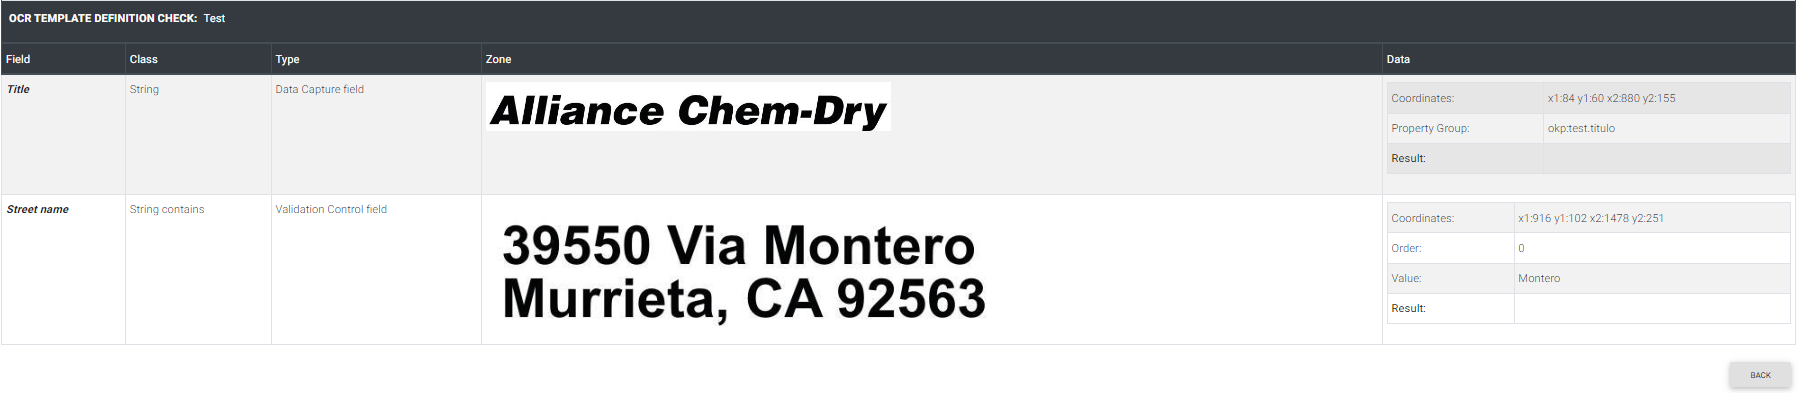
Comprobar una plantilla OCR
Sección titulada «Comprobar una plantilla OCR»- Haga clic en el icono
 Comprobar, y la plantilla OCR se comprobará.
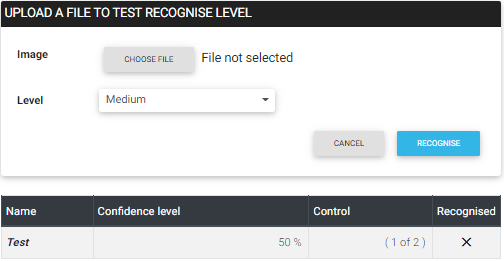
Comprobar el reconocimiento de un documento
Sección titulada «Comprobar el reconocimiento de un documento»- En la parte superior derecha, haga clic en
 el icono Reconocer.
- Elija el fichero a reconocer (tipos MIME permitidos).
- Elija el nivel de reconocimiento.
- Haga clic en el botón Reconocer.
Eliminar una plantilla OCR
Sección titulada «Eliminar una plantilla OCR»- Haga clic en el icono Eliminar plantilla OCR.
- Haga clic en el botón Eliminar.
Habilitar OCR Data Capture
Sección titulada «Habilitar OCR Data Capture»| Feature | Description |
|---|---|
| Pestaña General de perfil | Cuando OCR data capture está habilitado desde la pestaña General de perfil, el proceso de OCR Data Capture se ejecutará automáticamente para cada documento recién subido. Si hay presente una definición de automatización, estos parámetros no tienen efecto. Con la funcionalidad de automatización, todos estos casos y más quedan cubiertos. |
| Automatización | Validaciones: - Is OCRDataCaptureFile Más información sobre Plugins Built-in Automation Validator. Acciones: - OCR DataCapture - Add OCRDataCaptureToWizard Más información sobre Plugins Built-in Automation Action. |