Plantillas OCR
Las plantillas OCR permiten crear plantillas de OCR zonal que permiten reconocer y extraer texto estructurado de imágenes escaneadas.
Comprender las etapas de la ejecución de las plantillas OCR:
Recognise Extraction data Save data
Hay dos tipos de campos en las plantillas OCR:
- Campos de Validation Control.
- Campos de Data Capture.
Los tipos MIME permitidos en la etapa de reconocimiento son:
- PNG
- JPG
- GIF
- BMP
Descripción de los campos de Validation Control
Sección titulada «Descripción de los campos de Validation Control»Los campos de Validation Control se utilizan únicamente en la etapa de reconocimiento, para ayudar a identificar el documento comprobando el patrón de una sección del documento.
Cada campo de Validation Control se compone de:
| Field | Descripción | Requerido |
|---|---|---|
| Name | Nombre del campo. | true |
| Order | Orden de evaluación | true |
| Type | Lista de OCR Validation Controls. Cada validador es una condición que debe cumplirse. | true |
| Value | Un valor. | * |
| Pattern | Un patrón de expresión regular de Java. | * |
| Rotation | Indica la rotación de la imagen que debe aplicarse. Rotaciones de imagen disponibles: - -270 - -180 - -90 - 0 - 90 - 180 - 270 |
true |
| Custom | Establece comandos para procesar las imágenes por el OCR. Pueden establecerse varios comandos, uno por línea. Por ejemplo, para resaltar el color rojo /usr/bin/convert ${fileIn} -matte ( +clone -fuzz 50% -transparent red ) -compose DstOut -composite -negate ${fileOut} |
false |
| OCR | Línea de comandos del OCR. Cuando está presente, se ejecutará en lugar del parámetro de configuración system.ocr. Más información en Parámetros de configuración. Por ejemplo, para forzar la captura de dígitos. /usr/bin/tesseract ${fileIn} ${fileOut} digits |
false |
| Empty value allowed | Si está marcado, indica que un valor de texto vacío del ocr también es válido en el proceso de identificación del documento. | false |
| * Estos parámetros se utilizan en el Validation Control. Pueden ser requeridos o no, según el Validation Control que se utilice. |
Descripción de los campos de Data Capture
Sección titulada «Descripción de los campos de Data Capture»Los campos de Data Capture se utilizan para obtener datos en la etapa de extracción, pero también pueden utilizarse en la etapa de reconocimiento, para ayudar a identificar un documento comprobando el patrón de una sección del documento.
Cada campo de Data Capture se compone de:
| Field | Descripción | Requerido |
|---|---|---|
| Name | Nombre del campo. | true |
| Order | Orden de evaluación | true |
| Type | Lista de los OCR Data Capture. | true |
| Property | Campo de metadatos donde se almacenarán los datos capturados. | true |
| Pattern | Un patrón de expresión regular de Java. | * |
| Rotation | Indica la rotación de la imagen que debe aplicarse. Rotaciones de imagen disponibles: - -270 - -180 - -90 - 0 - 90 - 180 - 270 |
true |
| Custom | Establece comandos para procesar las imágenes por el OCR. Pueden establecerse varios comandos, uno por línea. Por ejemplo, para resaltar el color rojo /usr/bin/convert ${fileIn} -matte ( +clone -fuzz 50% -transparent red ) -compose DstOut -composite -negate ${fileOut} |
false |
| OCR | Línea de comandos del OCR. Cuando está presente, se ejecutará en lugar del parámetro de configuración system.ocr. Más información en Parámetros de configuración. Por ejemplo, para forzar la captura de dígitos. /usr/bin/tesseract ${fileIn} ${fileOut} digits |
false |
| Use to recognize | Cuando se establece en true, indica que el campo también se utilizará en la etapa de reconocimiento. | false |
| * Este parámetro se utiliza en el Data Capture. Puede ser requerido o no, según el Data Capture que se utilice. |
Comprender OCR Validation Control y OCR Data Capture
Sección titulada «Comprender OCR Validation Control y OCR Data Capture»La aplicación proporciona una lista completa de los OCR Validation Controls y OCR Data Capture disponibles en la vista Plugins. La arquitectura de plugins de la aplicación ayuda a los administradores a añadir nuevas funcionalidades a la aplicación existente.
Por defecto, la aplicación incluye los siguientes plugins integrados:
También pueden crearse plugins propios:
Crear una nueva plantilla OCR
Sección titulada «Crear una nueva plantilla OCR»- En la parte superior derecha, haga clic en el
 icono New OCR templace.
- Rellene los campos.
- Campo de metadatos (valores de metadatos estáticos, normalmente utilizados para identificar el tipo de documento).
- Elija el archivo (tipo MIME permitido).
- Haga clic en el botón Create.
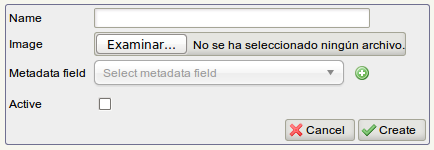
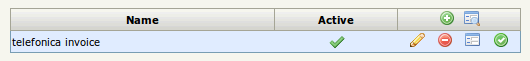
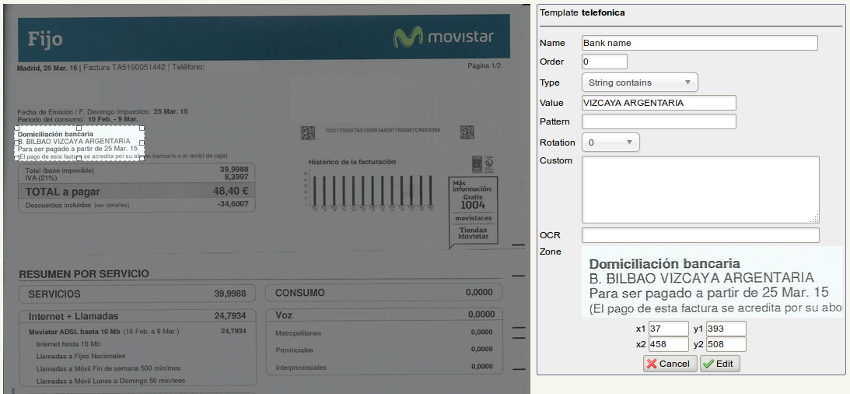
- Añada campos de Validation Controls según le convenga.
- Validation Controls
- Haga clic en
 Fields.
- Para crear un nuevo Validation Control:
- Haga clic en el
 icono New Validation Control Field.
- Rellene los campos.
- Elija el área con el ratón en la imagen de la izquierda.
- Haga clic en el botón Create.
- Haga clic en el
- Para editar un Validation Control:
- Haga clic en el
 icono Edit a Validation Control.
- Modifique los campos.
- Haga clic en el botón Edit.
- Haga clic en el
- Para eliminar un Validation Control:
- Haga clic en el
 icono Delete a Validation Control.
- Haga clic en el botón Delete.
- Haga clic en el
- Para crear un nuevo Validation Control:
- Haga clic en
- Validation Controls
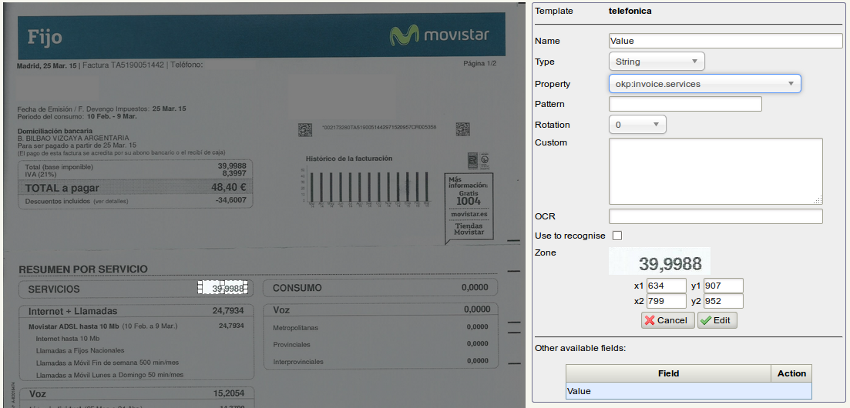
- Añada campos de Data Capture según le convenga.
- Data Capture
- Haga clic en Fields.
- Para crear un nuevo Data Capture
- Haga clic en el icono New Data Capture Field.
- Rellene los campos.
- Elija el área con el ratón en la imagen de la izquierda.
- Haga clic en el botón Create.
- Haga clic en el
- Para editar un Data Capture:
- Haga clic en el icono Edit a Data Capture.
- Modifique los campos.
- Haga clic en el botón Edit.
- Haga clic en el
- Para eliminar un Data Capture:
- Haga clic en el icono Delete a Data Capture.
- Haga clic en el botón Delete.
- Haga clic en el
- Haga clic en
- Data Capture
Editar una plantilla OCR
Sección titulada «Editar una plantilla OCR»- Haga clic en el icono Edit OCR template.
- Modifique los campos.
- Haga clic en el botón Edit.
Editar los campos de una plantilla OCR
Sección titulada «Editar los campos de una plantilla OCR»Editar un OCR Validation Control
Sección titulada «Editar un OCR Validation Control»Haga clic en Fields.
- Haga clic en el icono Edit a Validation Control.
- Modifique los campos.
- Haga clic en el botón Edit.
Editar un OCR Data Capture
Sección titulada «Editar un OCR Data Capture»Haga clic en Fields.
- Haga clic en el icono Edit a Data Capture.
- Modifique los campos.
- Haga clic en el botón Edit.
Eliminar los campos de una plantilla OCR
Sección titulada «Eliminar los campos de una plantilla OCR»Eliminar un OCR Validation Control
Sección titulada «Eliminar un OCR Validation Control»Haga clic en Fields.
- Haga clic en el icono Delete a Validation Control.
- Haga clic en el botón Delete.
Eliminar un OCR Data Capture
Sección titulada «Eliminar un OCR Data Capture»Haga clic en Fields.
- Haga clic en el icono Delete a Data Capture.
- Haga clic en el botón Delete.
Comprobar una plantilla OCR
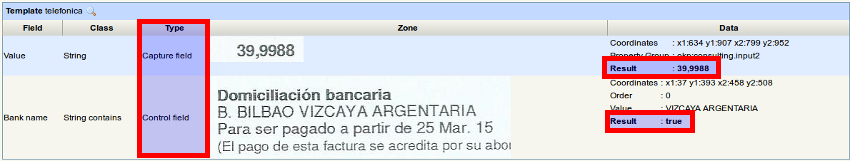
Sección titulada «Comprobar una plantilla OCR»- Haga clic en el icono Check
 y se comprobará la plantilla OCR.
Comprobar el reconocimiento de un documento
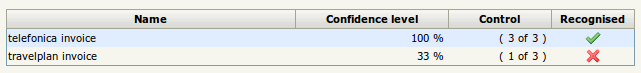
Sección titulada «Comprobar el reconocimiento de un documento»- En la parte superior derecha, haga clic en el
 icono Recognise.
- Elija el archivo que se va a reconocer (tipo MIME permitido).
- Elija el nivel de reconocimiento.
- Haga clic en el botón Recognise.
Eliminar una plantilla OCR
Sección titulada «Eliminar una plantilla OCR»- Haga clic en el icono Delete OCR template.
- Haga clic en el botón Delete.
Habilitar OCR Data Capture
Sección titulada «Habilitar OCR Data Capture»| Funcionalidad | Descripción |
|---|---|
| Pestaña General del perfil | Cuando el OCR data capture se habilita desde la pestaña General del perfil, el proceso de OCR Data Capture se ejecutará automáticamente en cada nuevo documento subido. En caso de que exista una definición de automatización, estos parámetros no tienen efecto. Con la funcionalidad de automatización se cubren todos estos casos y más. |
| Automatización | Validaciones: - Is OCRDataCaptureFile Más información sobre los plugins de Automation Validator integrados. Acciones: - OCR DataCapture - Add OCRDataCaptureToWizard Más información sobre los plugins de Automation Action integrados. |